

こんにちは!株式会社雲海設計の技術部です。
「LLM ハーネスという言葉を聞くようになったが、具体的に何を作れば『ハーネスがある』と言えるのか」「プロンプトを変えるたびに手動で品質チェックしているが、モデル更新のたびに全件やり直しでスケールしない」「Claude Opus 4.8・Sonnet 4.5・Mythos・GPT-5.5と選択肢が増えすぎて、どのモデルが自社ワークロードに最適か判断できない」——2026年7月現在、LLM ハーネスに関する相談が技術部に週5〜6件のペースで寄せられています。本記事では、単なる評価スクリプト集ではなく、評価データ設計・実行基盤・スコアリング・回帰CIを貫く実装ノウハウとして整理します。
TL;DR
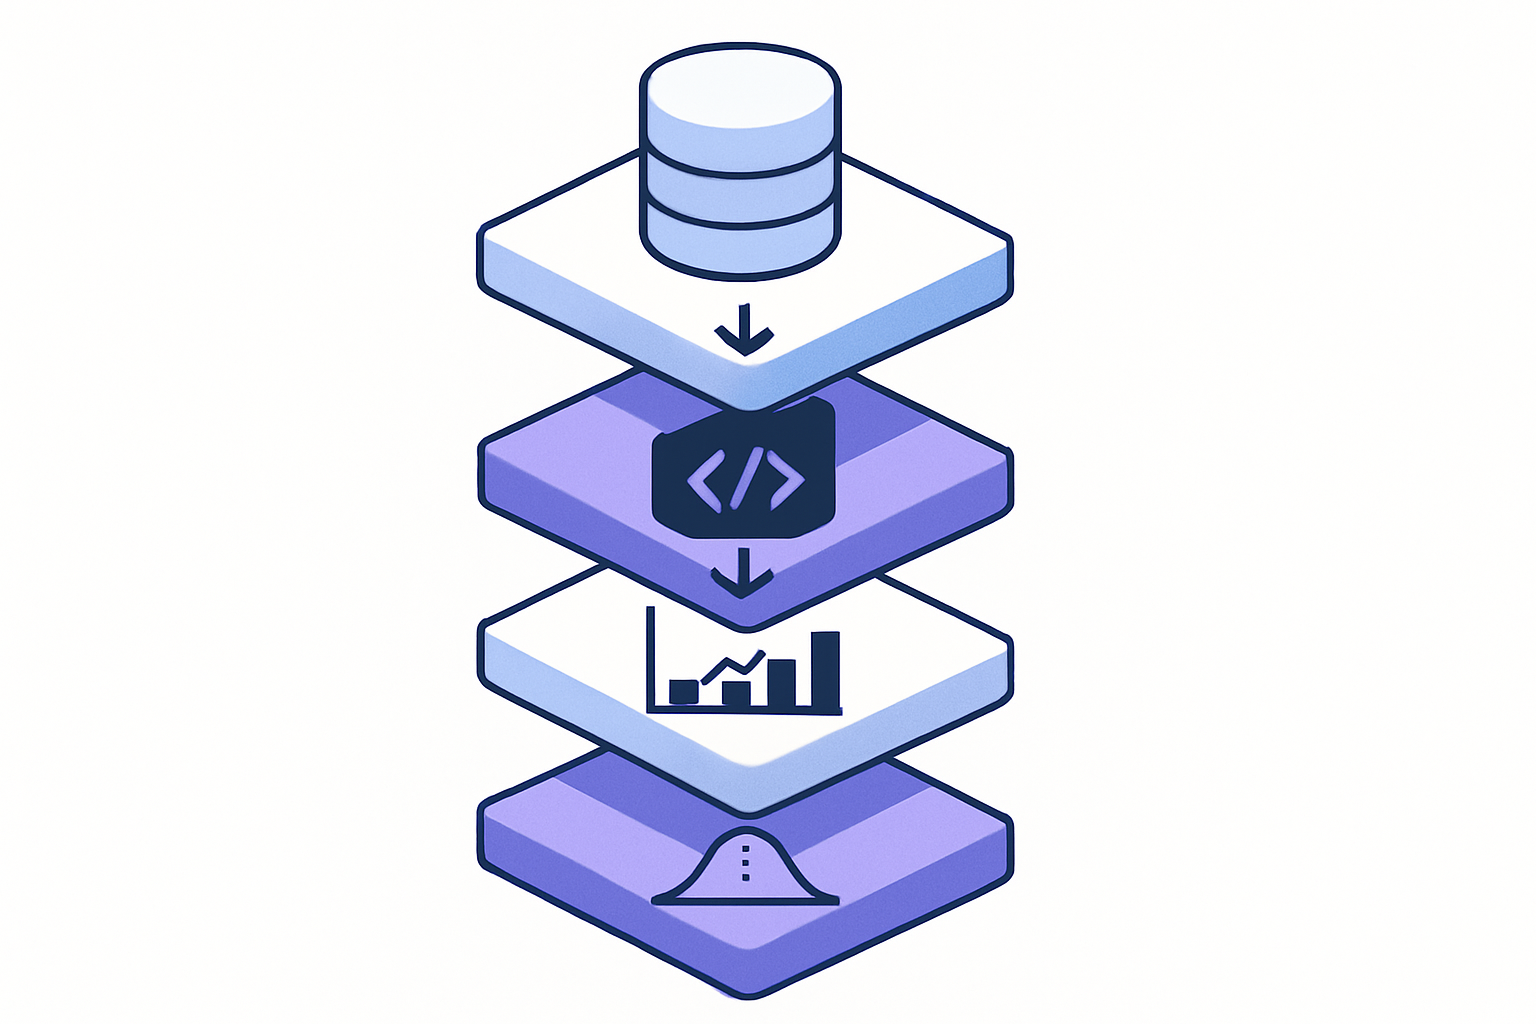
LLM ハーネスとは、LLMアプリケーションの品質を自動で測定・回帰検出する評価基盤の総称。「評価データ・実行ループ・スコアリング・回帰CI」の4層で構成される
2026年の業務適用では、ハーネスがない=本番投入不可と言い切れる段階。モデル更新頻度が年4〜6回に上がり、手動テストでは追随できない
評価データはゴールデンセット100件・回帰セット300〜500件・本番サンプリングの3層構成が実装定石
スコアリングはルールベース・LLM-as-Judge・人手の3段階を組み合わせる。単一手法だと必ずどこかで破綻する
回帰CIはGitHub Actions + 評価ダッシュボードの最小構成で始め、月100評価を超えたら専用基盤に移行
そもそも LLM ハーネスとは何か?
結論から言うと、LLM ハーネスとは、LLMアプリケーションの入力・出力・評価を自動化し、モデル更新やプロンプト変更時の品質劣化を検知する評価基盤です。単発の評価スクリプトではなく、継続的に回す仕組みであることが定義の核です。
この用語は元々ソフトウェアテスト分野の「テストハーネス」から派生しており、Anthropic が2025年秋の公式ドキュメントで「evaluation harness」を頻用したことで日本語圏でも定着しました。Gartner の2026年上期AI Engineering調査では、生成AIを本番運用している企業のうち68%が「何らかの評価ハーネスを保有している」と回答しており、2025年同時期の41%から急速に普及しています。
LLM ハーネスと従来のテスト自動化の違い
従来のユニットテストは「入力Xに対して出力Yが完全一致するか」を判定します。しかしLLMの出力は非決定的で、同じ入力でも微妙に文言が揺れます。そのためLLM ハーネスでは、以下のような従来テストにない要素が必須になります。
| 観点 | 従来のテスト自動化 | LLM ハーネス |
|---|---|---|
| 期待値 | 完全一致 | 意味的一致・スコア閾値 |
| 判定手法 | assertion | ルール + LLM-as-Judge + 人手 |
| 実行頻度 | PR毎 | PR毎 + モデル更新時 + 日次サンプリング |
| 失敗時の判断 | Fail/Pass | 閾値・傾向・回帰か否かの3判定 |
| コスト | ほぼゼロ | API課金が発生 (月数万〜数十万円) |
この違いを理解せずに「JestでLLMをテストすればいい」と発想すると、数週間で運用破綻します。実際、当社に持ち込まれる相談の6割はここでつまづいています。
なぜ2026年に LLM ハーネスが必須になったのか?
結論から言うと、モデル更新頻度の急上昇とエージェント化の進展が、手動評価を実務的に不可能にしたからです。
2025年前半までは、GPT-4系・Claude 3.5系が半年〜1年単位で安定していました。しかし2025年秋以降、Anthropic は Claude Opus 4.8・Sonnet 4.5・Mythos を立て続けに投入し、OpenAI も GPT-5.5 をリリース。モデル更新が2〜3ヶ月に1回のペースに加速しています。プロンプトも「1つのタスクに3〜5段のツール呼び出し」が当たり前になり、手動テストの組み合わせ爆発が起きています。
「エージェント化が進むと、単一プロンプトの品質ではなく、多段推論の破綻率が業務価値を決める。これを人手で追う時代は終わった」——Forbes Tech Council 2026年6月寄稿
雲海設計の現場でも、2025年末までは月10〜20件のプロンプト検証を人手でやりくりできていましたが、2026年に入ってからは月200件超の評価点が発生する案件が複数走っており、ハーネスなしでは回らなくなりました。より基礎的な解説はハーネスエンジニアリングとは?入門記事もあわせて参照ください。
LLM ハーネスを構成する4層アーキテクチャ
結論から言うと、実務で使えるLLM ハーネスは「評価データ・実行ループ・スコアリング・回帰CI」の4層で設計します。どれか1層が欠けると必ず運用で破綻します。
第1層: 評価データセット
評価データは以下の3種類を用意します。
ゴールデンセット (100件前後): 業務上「これだけは絶対に外せない」典型ケース。人手で正解を作り込む
回帰セット (300〜500件): 過去に発生した不具合ケースを蓄積。再発防止用
本番サンプリング (継続追加): 本番トラフィックから日次で数十件をサンプリング。分布ドリフトを検出
ゴールデンセットの設計品質が全体を決めます。ここで手を抜くと「動いてるように見えて本番で事故る」典型パターンに陥ります。
第2層: 実行ループ
実行ループは評価データを流し込み、対象LLMの出力を取得する層です。実装のポイントは以下です。
# 最小構成の実行ループ (擬似コード)
import anthropic
from concurrent.futures import ThreadPoolExecutor

client = anthropic.Anthropic()

def run_case(case):
    resp = client.messages.create(
        model="claude-opus-4-8",
        max_tokens=2000,
        messages=[{"role": "user", "content": case["input"]}],
    )
    return {
        "case_id": case["id"],
        "output": resp.content[0].text,
        "tokens": resp.usage.output_tokens,
    }

with ThreadPoolExecutor(max_workers=8) as ex:
    results = list(ex.map(run_case, eval_dataset))
並列度・リトライ・タイムアウト・トークン計測を必ず入れます。ここが雑だと評価に半日かかるようになり、開発速度が落ちます。
第3層: スコアリング
スコアリングは3段階の組み合わせが定石です。
| 手法 | コスト | 精度 | 用途 |
|---|---|---|---|
| ルールベース (正規表現・JSON schema) | ゼロ | 形式面のみ高精度 | フォーマット妥当性・禁則語 |
| LLM-as-Judge (Claude/GPTで採点) | API課金 | 意味面で中〜高精度 | 回答の妥当性・トーン |
| 人手レビュー | 時間コスト大 | 最高精度 | ゴールデンセットの最終確認 |
LLM-as-Judgeは便利ですが、Judge自体の評価バイアスがあるため、四半期に1回は人手で校正します。詳細はClaude ハーネス設計の実務ガイドにまとめています。
第4層: 回帰CI
回帰CIは、プロンプト変更・モデル更新のPRが上がるたびに自動で評価を回す層です。最小構成はGitHub Actions + 評価結果をSlackとダッシュボードに通知、で十分です。月100評価を超えたらLangSmith・Braintrust・Weights & Biasesなどの専用SaaSに移行します。フレームワーク比較記事でツール選定の勘所を整理しています。
LLM ハーネスを自社で作るべきか、SaaSに乗るべきか?
結論から言うと、月100評価未満は自作、それ以上は商用SaaS併用が2026年7月時点の実装解です。
自作が向くケース: 評価軸が業務特有・データ持ち出し不可・月100評価未満
SaaS併用が向くケース: 複数プロジェクト横断・可視化ダッシュボードが必要・月500評価超
ハイブリッドが多い: 実行ループは自作、スコアリング・ダッシュボードだけSaaSに載せる
いきなり大型SaaSに乗ると、「使いこなせず契約だけ残る」状態になりがちです。当社では最初の3ヶ月は必ず自作の最小構成で走らせ、痛みを把握してからSaaS選定に入ることを推奨しています。詳細な環境構築手順は環境構築ガイド2026にまとめました。
雲海設計の実装事例:製造業DX案件でのハーネス導入
2026年上期に当社が支援したある製造業クライアントでは、生産計画AIエージェントの品質評価が課題でした。当初は営業担当者が週次で30件をExcelレビューしていましたが、モデル更新のたびに全件やり直しで工数が膨張していました。
導入したのは以下の構成です。
ゴールデンセット120件を業務ヒアリングで作成 (2週間)
実行ループはPython + Claude Sonnet 4.5 で自作 (3日)
スコアリングはルールベース60% + LLM-as-Judge 40%
GitHub Actions で PR ごとに自動評価、Slack通知
結果、品質確認工数が週16時間から週2時間に削減、モデル更新時のリードタイムが従来2週間から3日に短縮しました。ハーネス自体の構築コストは約80万円、ROIは4ヶ月で回収されています。同様のROI設計についてはDX ROI測定フレームワーク2026もご参考ください。
導入時によくある落とし穴と回避策
結論から言うと、失敗パターンは「評価データ設計を軽視」「LLM-as-Judgeに全振り」「本番サンプリングを怠る」の3つに集約されます。
| 落とし穴 | 症状 | 回避策 |
|---|---|---|
| 評価データ100件未満で運用 | 統計的にモデル比較できない | 最低ゴールデン100 + 回帰300 |
| LLM-as-Judgeのみに依存 | Judgeのバイアスで甘い評価に | ルールベース併用 + 四半期人手校正 |
| 本番サンプリング省略 | 本番と評価データの分布乖離 | 日次20件サンプリング必須 |
| スコア閾値を決めない | PRごとに議論が発散 | 事前に「合格ライン85%」等を明文化 |
| コスト見積もり忘れ | 月末に予期せぬAPI課金 | 評価1回のトークン数を事前計測 |
特に3つ目の「本番サンプリング」は見落とされがちですが、ここが最も事故率が高い領域です。ユーザーは開発時に想定しなかった入力を投げてきます。
よくある質問
Q. LLM ハーネスとプロンプトエンジニアリングはどう違いますか?
A. プロンプトエンジニアリングは入力の設計、LLM ハーネスは出力の評価と回帰検出です。両輪の関係で、片方だけでは業務品質を担保できません。コンテキストエンジニアリングとの二段構え設計もあわせてご参照ください。
Q. 小規模チームでもLLM ハーネスは必要ですか?
A. 本番運用しているなら必要です。ただし規模に応じて簡易版で十分で、Pythonスクリプト100行 + スプレッドシートで始められます。月10評価程度ならこれで回ります。
Q. LLM-as-Judgeにどのモデルを使うべきですか?
A. 2026年7月時点では評価対象より1段強いモデルを推奨します。対象がSonnet 4.5なら、JudgeはOpus 4.8またはMythos。同一モデルで自己評価させると評価が甘くなる傾向があります。
Q. ハーネス構築の初期費用はどのくらいですか?
A. 業務要件の複雑さによりますが、当社実績では60〜150万円が中央値です。評価データ設計に最も時間がかかり、実装作業は全体の3割程度です。
Q. Claude Code や Cursor で LLM ハーネスを組めますか?
A. 組めます。むしろClaude Code は評価スクリプト生成に強く、Claude Code ハーネスエンジニアリング実装パターンで具体的な構築フローを解説しています。
まとめ:LLM ハーネスは2026年の必須スキル
LLM ハーネスは「あると便利」から「ないと本番投入できない」段階に移行しました。評価データ・実行ループ・スコアリング・回帰CIの4層を最小構成で組み、痛みを見ながらSaaS化・専門チーム化していくのが現実解です。
雲海設計では、LLM ハーネス設計・構築から、その後の運用改善までを一気通貫でご支援しています。「自社で組みかけたが評価データ設計で詰まった」「モデル切り替えの判断ができない」といったご相談は、DXソリューションまたはITコンサルティングのページからお気軽にどうぞ。個別ヒアリングをご希望の方はお問い合わせフォームまでご連絡ください。